课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
全局图景
- 在假设之内定理给出一个精确承诺。
- 旋转后的答案世界可能只能在正交坐标意义下被恢复。
- 海岸之外定理在那里保持沉默,不会神奇地自动为真或为假。
一个小故事:两张诚实的地图
两位制图师绘制同一座岛屿。其中一人把纸旋转了 90 度。每一段距离和每一次转移仍然一致,但“向上”已经不再意味着向北。两张地图都可以是正确的。
这就是为什么“在正交变换意义下可识别”是有意义、但有限的结论。学到的坐标通过旋转或反射,与隐藏坐标呈线性关系;单个坐标轴不必获得人类可读的名称。这比任意非线性扭曲更强,却比在第 1 个坐标中恢复“x 位置”更弱。
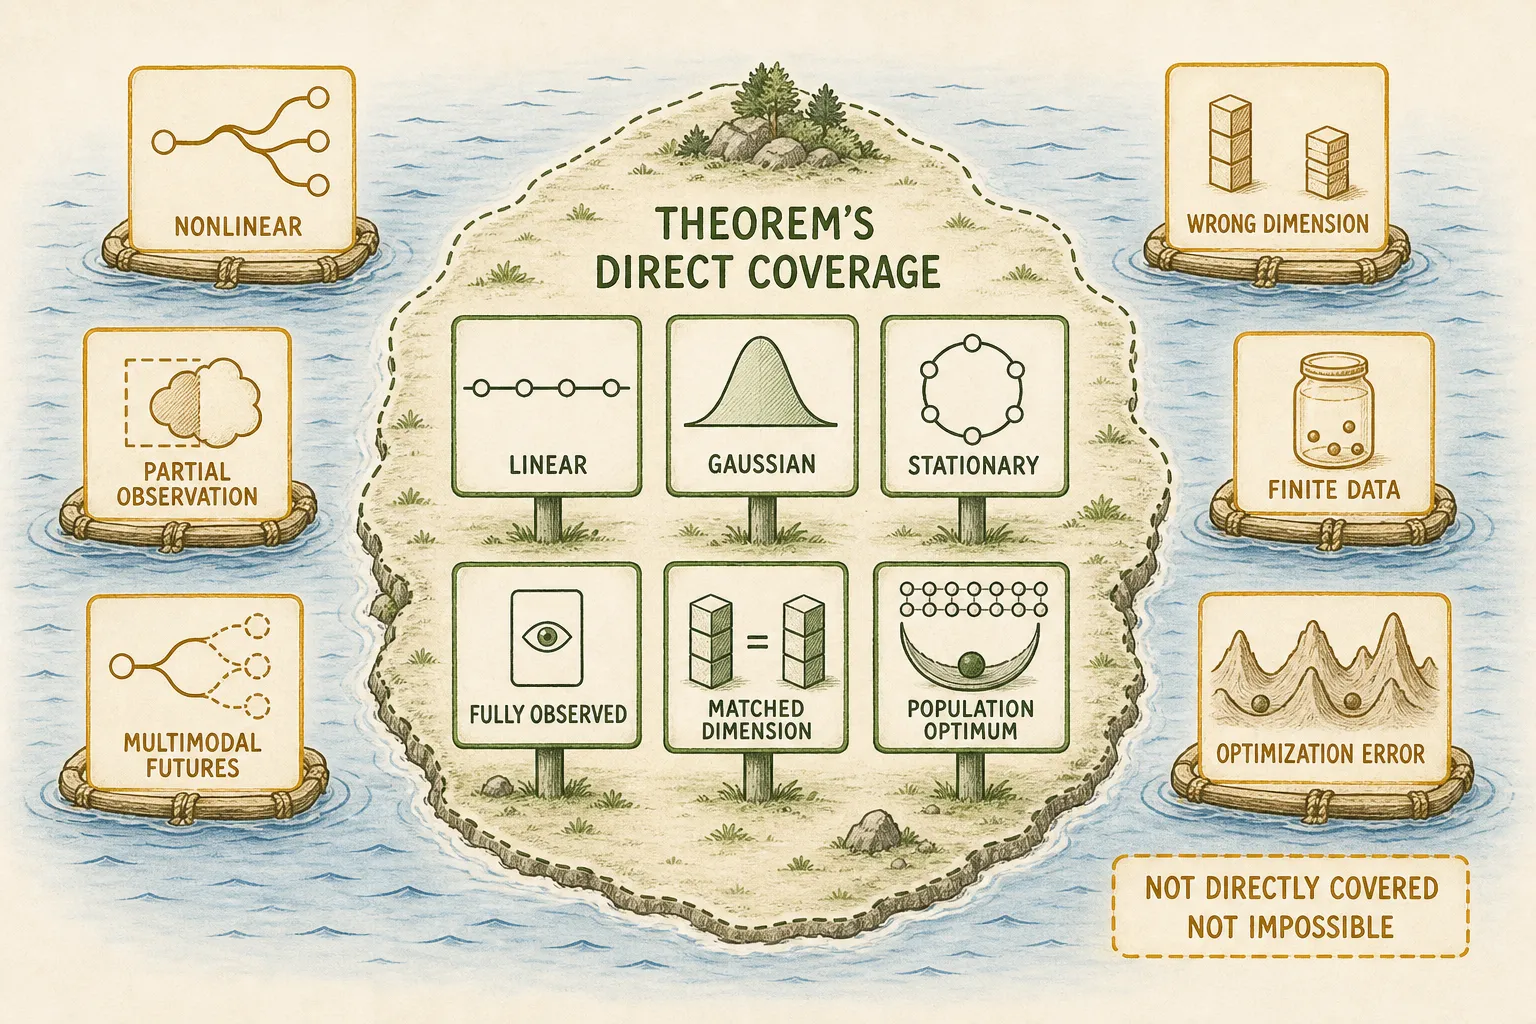
“位于外部”意味着“这些定理没有直接覆盖”,而不是“不可能学会”。
技术背包
When Does LeJEPA Learn a World Model? 中的被动结果,是针对一个明确类别的总体/全局最优声明:可通过指定观测映射观测的状态、平稳的加性噪声动力学、高斯潜在结构、精确高斯表示约束,以及匹配的潜在/表示维度。在它的分离条件下,可以在正交坐标意义下线性恢复状态。它的规划声明还额外要求变换后的动力学保持一致,且代价函数尊重正交歧义。但编码器定理本身并不说明模型学到了动作条件转移。
受控 v2 论文有一份不同、也更强的契约:可逆观测;具有独立高斯噪声的平稳线性受控潜在动力学;状态/动作行为联合高斯;精确高斯表示;匹配维度;表达力足够强的连续预测器;总体优化;以及正的状态条件动作激发。在这些条件下,它能在一个公共正交变换意义下,识别状态和受控条件均值转移。它不会恢复每一个随机未来。
三种常见假设缺口彼此不同:
- 部分可观测: 两个隐藏状态可能产生同一幅当前图像。只有当隐藏变量留下过痕迹时,历史才能帮上忙。
- 多模态未来: 平方误差点预测可能落在多个真实模式之间;条件均值不是完整的未来分布。
- 缺失干预: 总体上同时看到向左和向右并不足够;如果每个动作都只在一种状态中发生,反事实动作分支仍无约束。
有限网络中的 SIGReg 对有限小批次、采样投影和数值节点施加压力,使其接近高斯目标。这不是精确的总体约束。那篇独立的自由能论文假设编码器噪声恒定,且精确各向同性高斯约束已成功实现;它不是可识别性定理,并将经验验证留给了未来工作。
尝试推翻这个想法
构造两个状态。在状态 A 中,行为策略总是选择向右;在状态 B 中,它总是选择向左。整个数据集中两种动作的出现次数完全一样,但每个状态内都没有同时出现两条分支。预测器可以拟合每一条记录转移,却能对 A+Left 或 B+Right 随意编造结果。
再加入第二个数据集:两个状态中都同时包含两种动作,其余观测、状态分布、模型和更新次数全部保持不变。同时加入一个预言机状态条件。如果在预言机观测下,未见动作误差仍然存在,那么在这个构造中,问题在于转移覆盖,而非表示歧义。该测试支持的是条件激发机制;它不会诊断所有 LeWM 失败。
在引用一条定理之前,询问:观测是否具有足够的可逆性?转移/噪声族是否匹配?平稳性、维度、高斯约束和全局最优是否真的可用?在以状态为条件后,所需的每个动作方向是否都在变化?答案未知,意味着“将其作为指导”,而不是“声称已被覆盖”。
实验凭据与证据边界
- When Does LeJEPA Learn a World Model? v1,发布于 2026-05-25;公开快照
de7503f。 - On the Identifiability of Controlled World Models v2,修订于 2026-07-27;截止日前未找到作者关联实现。
- The SIGReg Objective as Variational Free Energy v1,发布于 2026-07-15;以及 LeWorldModel v3,固定代码
8edfeb3,后者仅用于界定实际基线边界。 - 证据截止时间:2026-08-20,Asia/Tokyo。理论证据受假设边界约束;若存在演示,则属作者自报;此处并未建立独立复现。绝不要把正交恢复说成有名物理坐标,把探针说成可识别性,或把线性条件均值定理说成有保证的非线性规划。
三个快问快答
- 正交歧义会保留什么,又会改变哪些语义名称?
- 为什么边缘动作多样性弱于状态条件动作激发?
- 当一个基准位于某条定理的假设之外时,正确的结论是什么?