课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
全局图景
- 为轴命名谁、何时、什么?
- 检查点云中心、离散、形状
- 度量偏差只是一把局部尺子
- 搜索未来采样、保留、收窄
一个口袋故事
想象一间装有十台仪器的控制室。一台给箱子贴标签,三台描述人群,一台打光观察投影,一台追踪责任流向,一台测量偏差,一台观察误差如何走向未来,一台向抽样证人提问,最后一台派出搜索队。
即使十台仪器全都亮绿灯,智能体仍可能选择一条穿墙而过的不可能捷径。这正是本附录的教训:一项正确的测量也可能回答错问题。相信一个数字之前,先问:“这个工具负责什么工作?它又不可能知道什么?”
技术背包
1. 先贴标签,再做运算
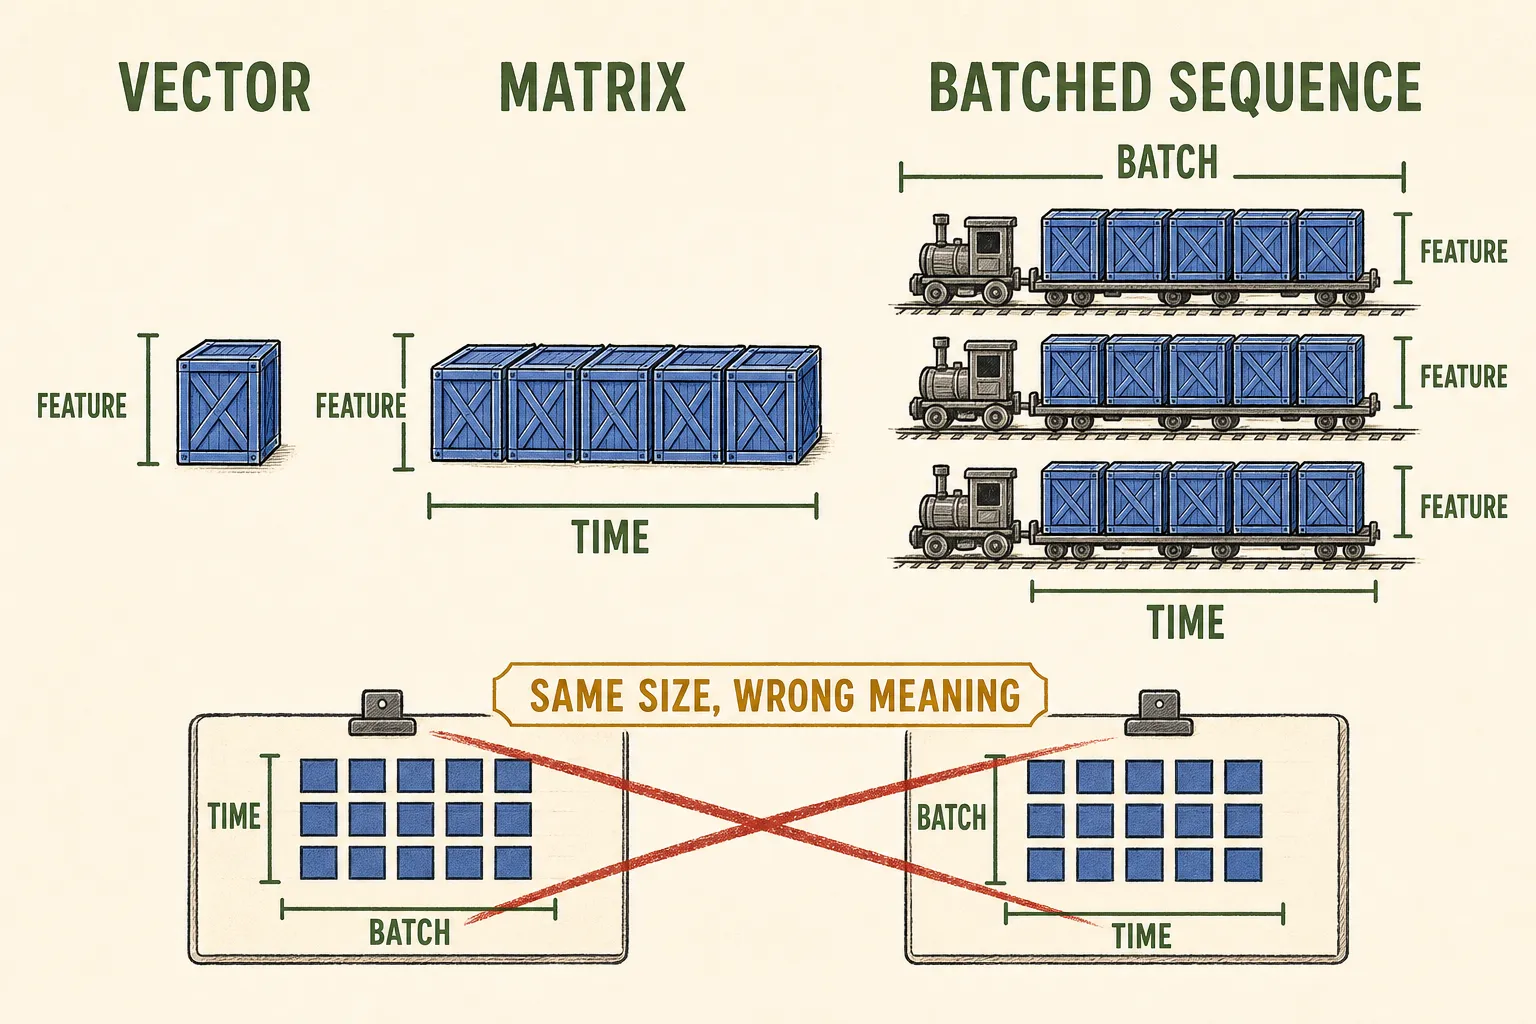
一个向量是一张状态卡;一个矩阵是一张卡片表;一个张量则增加了更多有标签的轴。[B,T,D] 表示批次、记录时间和潜在特征。规划时,[B,N,H,D] 表示环境批次、候选、模型视界和潜在特征。两个张量可以包含相同数量的值,却会在一次轴交换后讲出完全不同的故事。请把每条轴的名字都说出来。
2. 描述人群的三种摘要
对于潜在向量 z1 ... zn,均值是这群点的中心:
mean = (z1 + ... + zn) / n方差衡量单个坐标方向上的离散程度。协方差询问不同坐标是否一起变化;它的谱则显示变化铺展在许多方向上,还是只落在一张薄片里。这些指标是警报器,而不是意义证书。一个特征可能只因为亮度变化才变化;两个点云也可能拥有相同的均值和协方差,却在空洞、分支或罕见接触状态上完全不同。
SIGReg 把总体推向各向同性标准高斯:以零为中心、广泛铺展,而且没有特权方向。这样可以排除“所有输入都用同一个编码”的精确崩塌,却不能证明门口、位置或物理量获得了有用坐标。在高维空间里,密度在原点最高,但大部分径向概率质量落在一个宽壳层中;“高斯”并不等于“每个点都停在零点”。
3. 投影与梯度
随机投影把高维点云变成一维影子。Cramér–Wold 思想指出:如果一个分布在每个方向上都一致,就能识别这个分布。实际的 SIGReg 只能看到有限方向、有限小批次和有限数值积分。它是一种反复施加的压力,而不是高斯性证书。
梯度是一条局部的责任路径。在原始 LeWM v3 中,只有一个共享且可训练的视觉编码器。下一观测目标仍连接在计算图上:没有加入停止梯度、EMA 教师或预训练冻结编码器。因此,预测损失会同时到达预测分支和移位后的目标分支;SIGReg 则到达投影后的观测嵌入。路径存在,不代表信号一定足够强、尺度合适或真正有帮助。lambda 只负责平衡总体形状压力与预测压力。
4. 尺子、踏脚石与证人
均方误差比较对应坐标,并对更大的坐标差施加更强惩罚:
MSE = mean((predicted_next_latent - connected_next_latent)^2)它只说明指定向量在这把尺子下很接近。它并不说明潜在表示没有崩塌、动作确实起作用、滚动能够稳定,或目标可达。即使可行路线很长,终点距离的平方也可能把墙两侧的两个状态排成“很近”。
教师强制的单步预测踩在已记录观测上。自回归滚动则把下一块踏脚石放在模型自己生成的石头上。误差可能累积、抵消、饱和,也可能在门口或接触边界附近触发分支切换;不存在一条普适的增长曲线。
当枚举成本过高时,蒙特卡洛估计会向抽样证人提问。更多合适且独立的样本可以降低采样噪声,却无法修复模型偏差、数据支持域缺口或错误的代价函数。
5. CEM 是搜索队
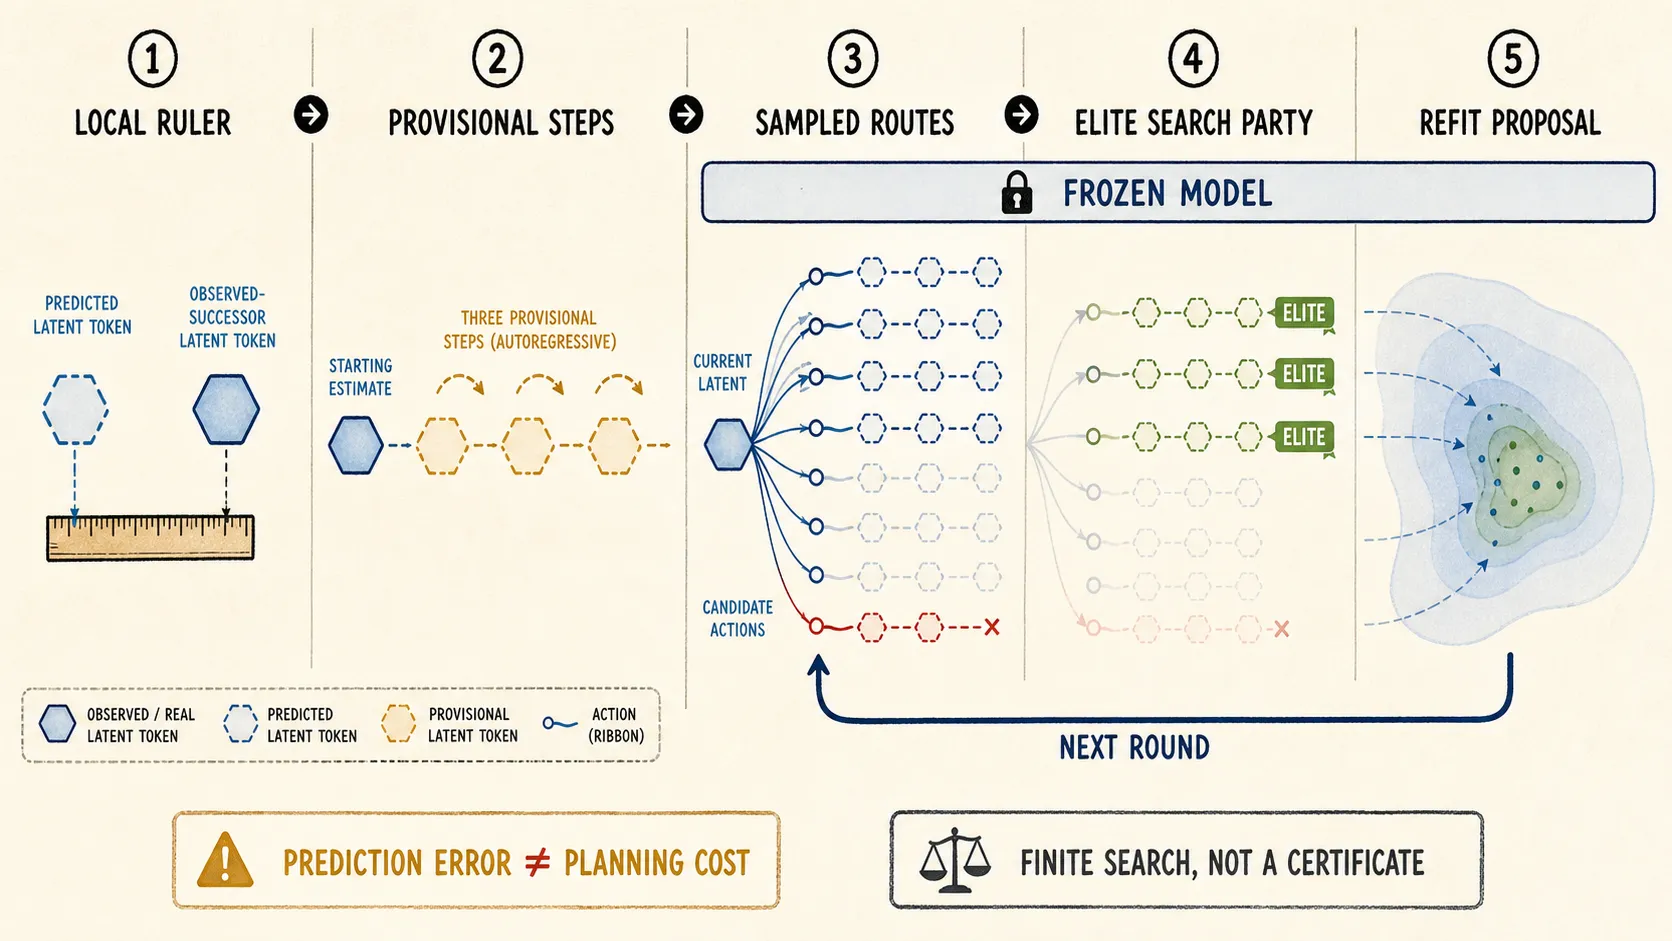
start with a broad action proposal
repeat for a configured number of rounds:
    sample candidate action sequences
    imagine endpoints with the frozen world model
    rank endpoints with the configured cost
    refit the proposal toward the elite candidates
return the configured output (paper Appendix B prose: final proposal mean)
CEM 改变的是动作提议分布,而不是编码器或预测器权重。从未被采样的候选不可能成为精英;提议分布也可能过早收窄;更强的搜索还可能更有效地利用模型或代价中的漏洞。有限轮次的 CEM 不是全局最优证书。
骗过我们的把戏
假设均值、方差、协方差、抽样投影和单步 MSE 看起来都很健康,CEM 也尖锐地收敛了。现在却发现:TwoRoom 墙体两侧在潜在空间中是邻居,因此终点距离会奖励穿墙。
仪表盘上的任何一项计算都不必出错。总体统计描述的是全局形状;MSE 描述的是已记录的局部转移;CEM 优化的是冻结模型与所选代价。它们都没有直接测试路线可达性。
一个有用的实验会把这些问题拆开。固定一组门口案例,记录总体几何、动作互换、单步误差、按视界划分的自馈误差、预测路线、代价排序和真实执行结果。如果增加 CEM 样本只让不可能的捷径更稳定地获胜,那么在继续扩大搜索前,应先调查模型支持域与代价几何。
证据凭据
LeWorldModel v3 以及冻结在 8edfeb336732b5f3ce7b8b210d0ba370a09e2cac 的官方代码支持共享编码器连通计算图及其规划角色。LeJEPA v3、Epps–Pulley 检验和 Cramér–Wold 定理支持这一受假设约束的投影动机。
允许的说法是:在具名假设下,这些工具描述张量含义、总体摘要、局部预测间隙、随机估计和有限搜索。不允许的说法是:健康的统计量证明了语义状态恢复;有限投影证明了高斯性;低 MSE 证明了可达性;增加样本能够修复错误模型;CEM 证明了全局最优。本节并未建立独立复现。
快速检查
- 为什么一次保持形状不变的轴交换仍可能破坏系统?
- 为什么一个看起来像高斯的潜在点云仍可能忘掉门口?
- 如果 CEM 很自信地选择了一条不可能路线,接下来你会把哪些测量拆开?