课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
先看全景
- 冻结保持一个明确命名的表征不变。
- 划分回合不让相邻帧泄漏。
- 拟合读出器先用线性直尺,再用受控 MLP。
- 只说“可恢复”是否被使用需要另一项测试。
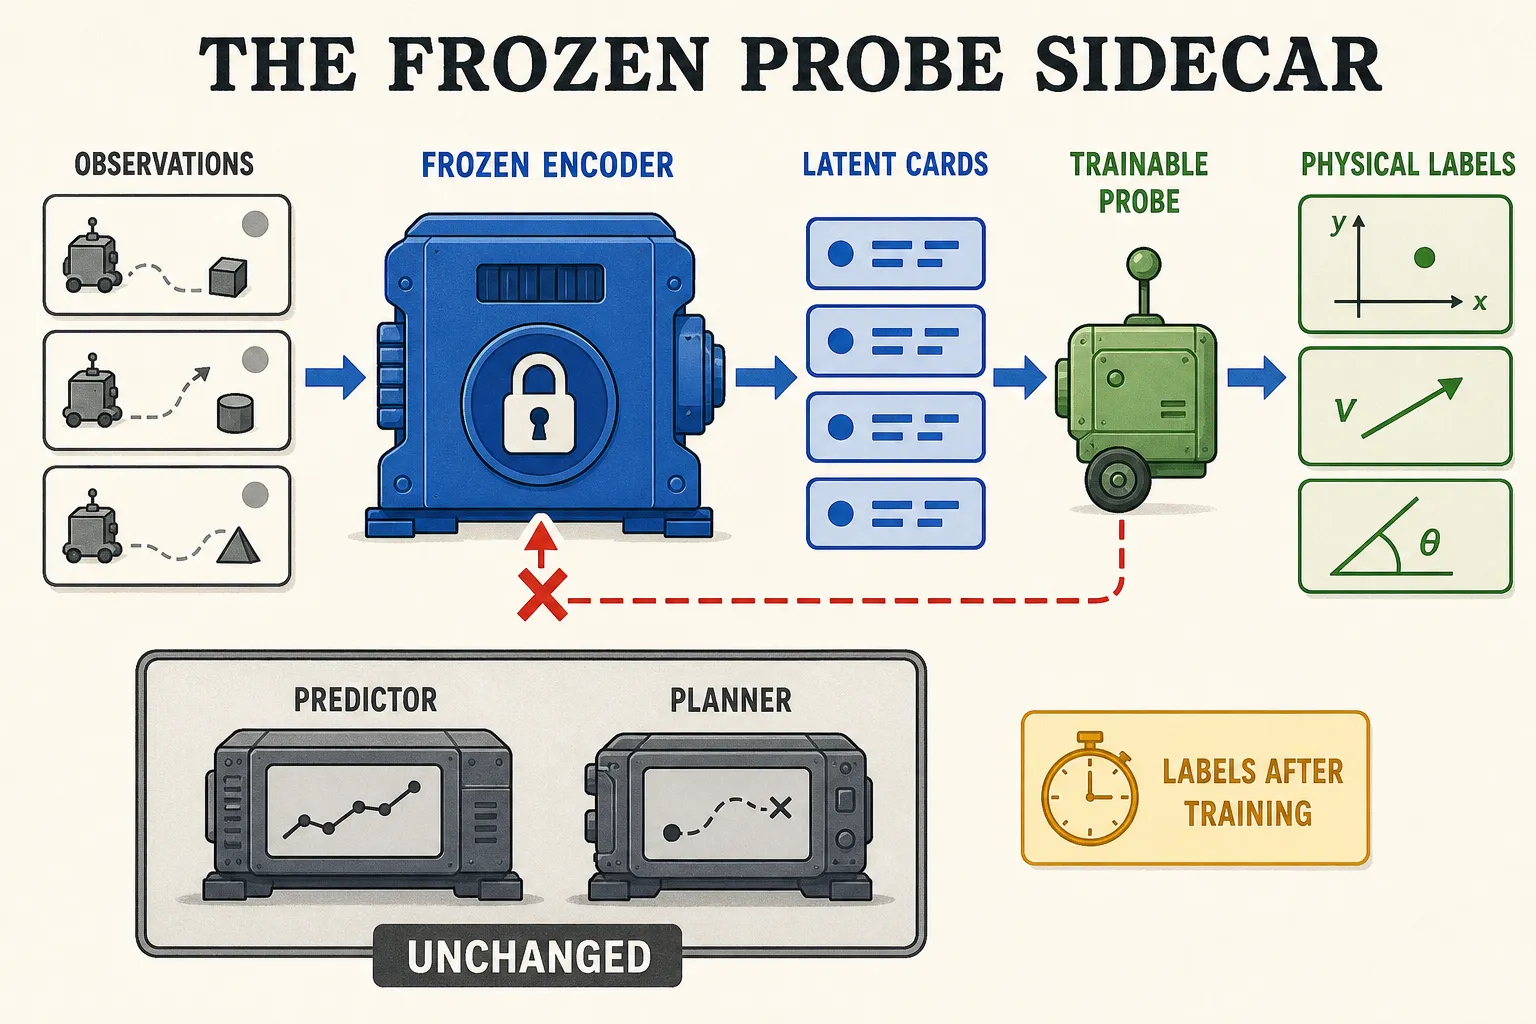
一个小故事
机场扫描仪能看见行李箱中的钥匙。这说明扫描仪可以从当前视角恢复钥匙信息,却不能证明旅客知道钥匙在那里,也不能证明旅客会使用它。
探针的工作方式相同。冻结训练后的表征,收集其潜在向量,再训练一个小型读出器,把这些向量映射到模拟器标签。成功读出说明:对于这个表征、读出器、数据划分和分布,该信息在统计上可以访问。它不能证明预测器或规划器会使用该信息。
真正规则
明确指出连接位置:编码器输出、投影后的状态、预测器输入和预测器输出是不同对象。冻结检查点、评估模式、裁剪、缩放、归一化、池化、投影器和历史构建方式。如果探针梯度更新了编码器,实验就已经变成监督微调。
应在提取嵌入或拟合目标归一化之前,划分完整回合。在训练回合上训练,在验证回合上选择超参数,最后只在从未触碰的测试回合上评估一次。随机帧划分把相邻帧放在两侧时,它们是近似重复样本,并不代表独立泛化。
LeWM v3 报告了下列探针目标:
- TwoRoom:二维智能体位置;
- PushT:智能体位置、物块位置、物块角度;
- OGBench-Cube:关节位置/速度、末端执行器位置/yaw、夹爪状态、物块位置/quaternion/yaw。
目标距离是教程扩展,不是 v3 探针目标。论文为线性和非线性探针报告 MSE 与 Pearson 相关系数。存在尺度偏差时,相关系数仍可能很高;平均 MSE 则可能掩盖某个糟糕维度或罕见接触切片。
线性探针测试简单的仿射可访问性。MLP 测试更丰富假设类中的可访问性,也可能利用捷径。二者都应报告容量、正则化、优化和调参预算。
可能骗过我们的把戏
设想每个 TwoRoom 回合都在大致相同的时间穿过门口,并且角落中有一个微弱标记会随帧索引变亮。随机帧划分会让 MLP——甚至线性探针——通过时间预测位置。
现在改为按回合划分、随机改变策略速度,并移除标记。如果性能下降,原结果仍然只意味着这一点:在时间与位置耦合的场景中,位置可以恢复。
使用下列对照:常量均值预测器、简单像素或特权可观测量基线、未训练编码器、打乱标签,以及训练与测试曲线。TwoRoom 按开阔地面、墙壁和门口切片;PushT 则在标签可靠时,按自由移动、接近、首次接触、滑动和旋转切片。
若要测试信息是否被使用,应在探测之后进行干预。扰动与某变量相关的子空间,并在相同回合和候选动作上,与等大小的随机方向、保范数噪声和不干预设置比较。行为改变仍可能来自纠缠,或落入分布外潜在状态;因此即便如此,也只能支持“在该项干预下与行为有关”,不能自动建立因果性。
实验凭据
后续结果让这条边界变得具体:
- Objective Bottleneck 报告,在一个 TwoRoom 后续系统中,终端潜在 L2 与真实终点距离之间 Pearson (r=0.426),而 ridge 位置探针在留出数据上达到 (R^2=0.9922)。
- SCALE 报告,一项状态回归对照在部分任务上能够达到或超过完整嵌入的可解码性,却不能达到同样的距离对齐;与之相比,SCALE 在 15 个任务—求解器平均值中改善 15 个,该对照改善 13 个。
- Decision-Metric Alignment 报告,四种未崩塌 PushT 变体之间的探针 (R^2) 差异小于 0.03,而 Plan–Real Spearman 从 +0.280 提高到约 +0.410–+0.420,在线成功率范围为 49.3%–92.7%。每项配置只有一次训练运行;三个随机种子测量的是评估变异。
这些是彼此独立、由作者报告的协议。它们说明可解码性可以与面向规划器的几何分离;却不能确定某个通用机制。原始 v3 的探针实现细节不足以精确重建每一项报告中的探针。
快速检查
- 为了让探针描述原始表征,什么必须保持冻结?
- 相比线性探针成功,MLP 成功多说明了什么,又不能说明什么?
- 哪种干预能把主张从“可恢复”推进到“与行为有关”?