JEPA4Japan · 教程

第 28 章——预期违背:模型会对“不可能事件”感到惊讶吗?

1,382字 4分钟阅读 #LeWorldModel#世界模型#JEPA

比较正常动力学与受控违背,用潜在预测误差定义惊讶,并说明所得证据能证明什么、不能证明什么。

课程进度 课程大纲 已发布 48/48 课

第 0 部分——阅读指南:我们究竟要学什么?

  1. 01 第 0 章——开始之前 已发布

第 1 部分——世界模型:智能体内部的沙盒

  1. 02 第 1 章——智能体为什么需要“想象未来” 已发布
  2. 03 第 2 章——为什么不直接预测下一张图像? 已发布
  3. 04 第 3 章——JEPA 思想:预测意义,而不是图像的复制品 已发布
  4. 05 第 4 章——用一张图看懂 LeWM 已发布

第 2 部分——把图像变成状态:LeWM 架构

  1. 06 第 5 章——轨迹数据:对模型而言,世界不是图像集合 已发布
  2. 07 第 6 章——视觉编码器:为每一帧签发“状态护照” 已发布
  3. 08 第 7 章——动力学预测器:在头脑中推动时间前进 已发布
  4. 09 第 8 章——一次完整的前向传播:跟随一个批次从头走到尾 已发布

第 3 部分——防止模型作弊:预测损失与 SIGReg

  1. 10 第 9 章——最危险的捷径:表示崩塌 已发布
  2. 11 第 10 章——预测损失:模型怎样学习下一步 已发布
  3. 12 第 11 章——SIGReg 的直觉:让表示空间“呼吸” 已发布
  4. 13 第 12 章——只保留最少却足够的数学 已发布
  5. 14 第 13 章——原始 LeWM 的端到端训练机制 已发布
  6. 15 第 14 章——训练一个不会立即崩塌的模型 已发布

第 4 部分——让模型行动起来:在潜在空间中规划

  1. 16 第 15 章——目标条件规划:从“我在哪里?”到“我要去哪里?” 已发布
  2. 17 第 16 章——潜在欧氏距离:方便,但未必可靠 已发布
  3. 18 第 17 章——CEM:用淘汰赛搜索动作 已发布
  4. 19 第 18 章——MPC:不要一次信任模型太久 已发布
  5. 20 第 19 章——长视界滚动:小误差怎样滚成大失败 已发布
  6. 21 第 20 章——从零实现一个最小 LeWM 规划器 已发布

第 5 部分——工程复现:从论文到可运行系统

  1. 22 第 21 章——官方代码仓库与实验环境 已发布
  2. 23 第 22 章——第一个实验:TwoRoom 冒烟测试 已发布
  3. 24 第 23 章——第二个实验:复现 PushT 已发布
  4. 25 第 24 章——怎样公平评估世界模型 已发布
  5. 26 第 25 章——失败诊断手册 已发布

第 6 部分——LeWM 究竟学到了什么?

  1. 27 第 26 章——线性探针:潜在状态编码了哪些物理变量? 已发布
  2. 28 第 27 章——为潜在空间做一次“健康检查” 已发布
  3. 29 第 28 章——预期违背:模型会对“不可能事件”感到惊讶吗? 当前课程
  4. 30 第 29 章——怎样严谨讨论“理解世界” 已发布

第 7 部分——为什么“预测准确”仍可能“规划很差”

  1. 31 第 30 章——训练目标与规划目标之间的差距 已发布
  2. 32 第 31 章——全局不崩塌不保证保留任务相关动力学 已发布
  3. 33 第 32 章——各向同性高斯先验何时过强? 已发布
  4. 34 第 33 章——长视界规划:预测得更远,还是规划得更聪明? 已发布
  5. 35 第 34 章——从位置距离到任务进度 已发布
  6. 36 第 35 章——多任务学习、真实机器人与视觉干扰 已发布
  7. 37 第 36 章——理论边界:何时能辨识真实状态? 已发布

第 8 部分——从复现者到研究者

  1. 38 第 37 章——设计一项可信的 LeWM 改进实验 已发布
  2. 39 第 38 章——十二个可执行的研究项目 已发布
  3. 40 第 39 章——LeWM 研究中的开放问题 已发布

附录

  1. 41 附录 A——最低限度的必需数学工具箱 已发布
  2. 42 附录 B——PyTorch 实现速查 已发布
  3. 43 附录 C——完整张量形状表 已发布
  4. 44 附录 D——实验配置卡 已发布
  5. 45 附录 E——论文时间线与证据等级 已发布
  6. 46 附录 F——术语表 已发布
  7. 47 附录 G——复现检查清单 已发布
  8. 48 附录 H——专家审阅检查清单 已发布

先看全景

  1. 预测接下来应该出现什么?
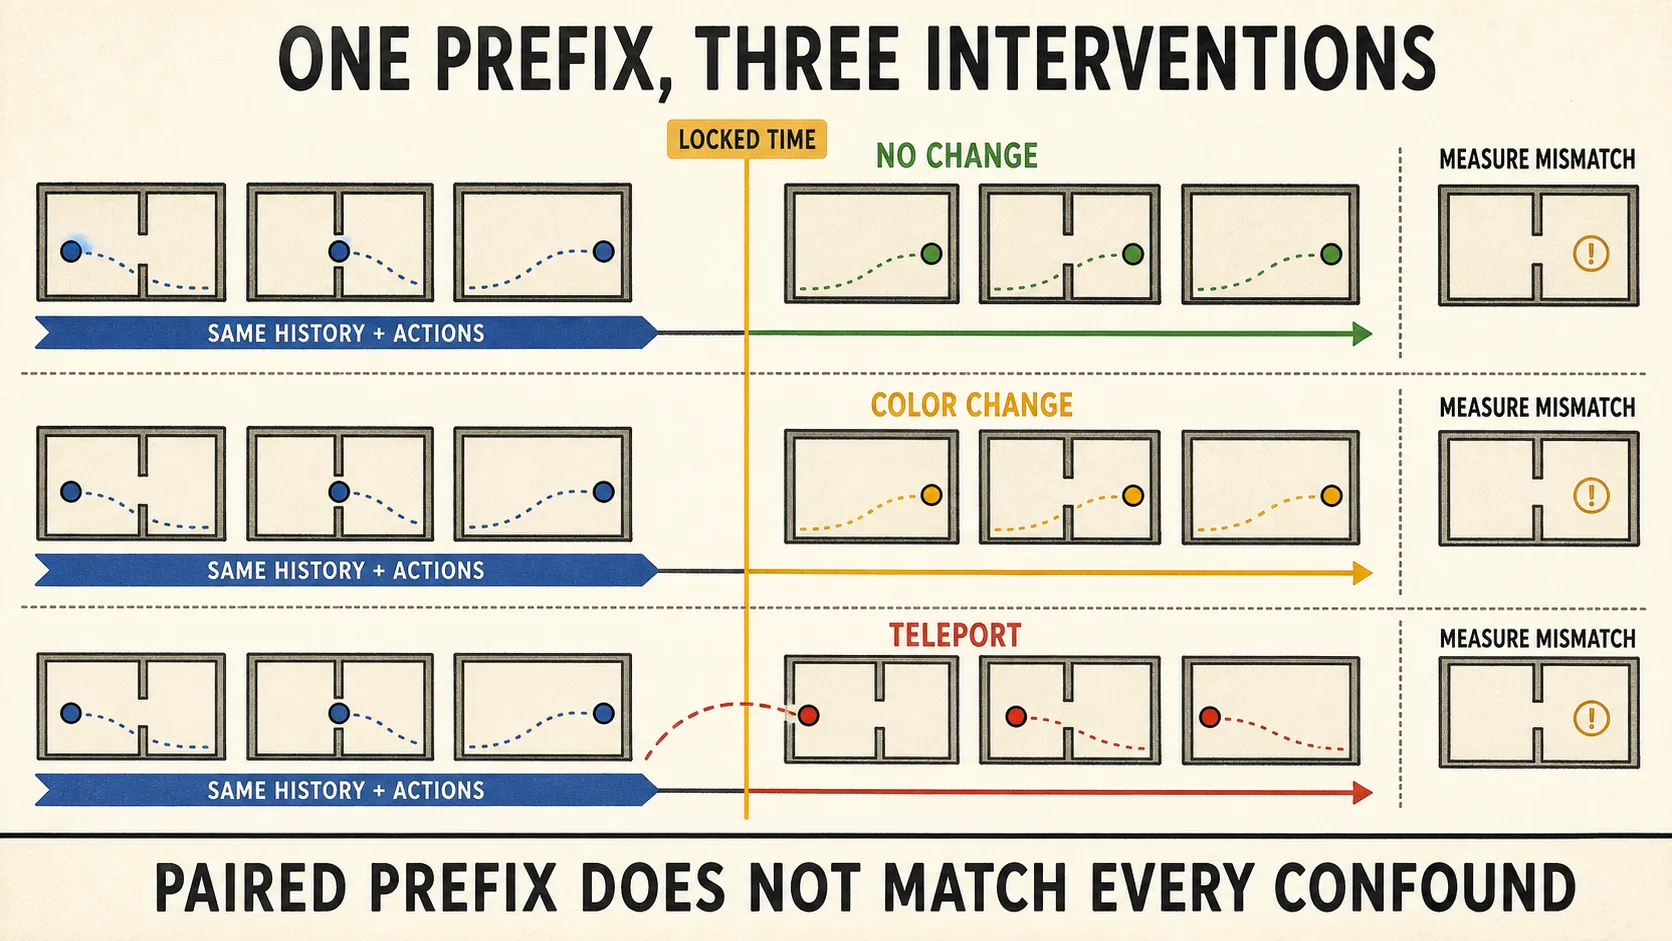
  2. 只改变一件事颜色、状态或支持范围。
  3. 测量失配峰值代表敏感性,不代表信念。
“惊讶”是一个明确命名的预测误差,并不能证明模型知道什么是不可能的。

匹配的轨迹共享历史与动作,随后分支为无变化、颜色变化和瞬移。

一个小故事

一只球消失在幕布后,又出现在舞台另一侧。孩子倒吸一口气,运动检测器也被触发。二者都作出了响应,但可能只有一个响应涉及物理预期。

违反预期(Violation-of-Expectation,VoE)测试先产生预期中的后续,施加干预,再测量预测与观测之间的失配。瞬移产生更大的峰值,首先只意味着被测事件与模型预测更加不符。它并不表示模型已经知道瞬移不可能发生。

真正规则

使用具有相同前史、动作、干预时刻和评估窗口的配对三元组:

  1. 未扰动的后续;
  2. 外观干预;
  3. 瞬移等状态不连续事件。

LeWM v3 报告了三个环境中的这类设计:

  • TwoRoom:智能体颜色变化与智能体瞬移;
  • PushT:物块颜色变化与智能体、物块同时瞬移;
  • OGBench-Cube:立方体颜色变化与立方体瞬移。

PushT 显然不是单因素的“颜色与物理”测试:瞬移分支改变了两个物体及其关系,而颜色分支只改变一个物体的外观。

论文报告,在配对检验阈值低于 0.01 时,三个环境中的瞬移都产生了显著更高的惊讶值;主图中的颜色效应则更弱且不显著。严谨表述是:在作者的协议下,LeWM 的失配信号对这些瞬移干预比对这些颜色干预更敏感。

冻结的公共仓库没有提供足够的 VoE 代码来恢复作者的精确归约方式。课程实现可以定义一个教学标量——预测下一潜在状态与冻结编码器为真实下一观测产生的潜在状态之间的逐坐标均方差——但必须标为教程诊断。

可能骗过我们的把戏

一个“最后一帧”预测器会直接把当前潜在状态复制到未来,并忽略动作。普通的缓慢运动只产生中等误差,瞬移产生较大峰值,很小的颜色变化则产生较小峰值。即使没有学习接触动力学,它也通过了最弱的排序检验。

加入下列对照,主动攻击这种解释:

  • 每个分支之后使用相同动作;
  • 让图像变化幅度重叠;
  • 使用支持范围内的快速运动,以及支持范围匹配的重置;
  • 采用位移匹配的单物体和双物体干预;
  • 最后一帧、静止潜在状态、动作打乱、仅外观和持续性基线。

检查完整时间曲线。干预之前就出现响应,说明可能存在泄漏或对齐错误。单步峰值随后恢复与持续平台不同,但二者都不能自行诊断原因。新观测可以重新锚定预测;持续误差则可能意味着不受支持的重置或自反馈漂移。

预先注册干预强度、支持范围分箱、失配归约方式、固定时间或峰值统计量、排除规则和回合级统计单位。不要在看过瞬移测试的峰值之后再拟合归一化。

实验凭据

归档最后一段干净历史、动作块、干预帧、干预前后观测、受影响物体、模拟器重置状态、策略、随机种子、检查点、连接位置和聚合规则。虚线表示的预测潜在状态必须与实线表示的编码观测明确区分。除非协议明确用解码图像定义误差,否则它只是另一个独立读出器。

后续的 ACPC v1 向干净历史和视觉扰动历史提供同一动作序列,并测量滚动展开的分歧。它引入 Invariance Radius(IR)和 Separation Rate(SR),给出了把分歧与多步预测误差联系起来的逐样本界;在共享候选池假设下,还把分歧与规划器代价变化联系起来。作者在四项任务上报告了每个条件三个随机种子的趋势,并公开代码 90d4276。筛选器使用观察到的源任务成功标签,并只测试一种模糊/缩放强度;它没有证明使用 ACPC 选择计划能够改善控制。

VoE 支持的是明确协议下的扰动敏感性。它本身不能证明物体恒存、因果物理、类人认知、规划器利用或对未见违规事件的泛化。

快速检查

  1. VoE 三元组中的哪些部分必须配对?
  2. 为什么 PushT 的颜色与瞬移比较不是单因素物理测试?
  3. 哪个简单基线也可能对瞬移表现出“惊讶”?