课程进度 课程大纲 已发布 48/48 课
第 0 部分——阅读指南:我们究竟要学什么?
第 1 部分——世界模型:智能体内部的沙盒
第 2 部分——把图像变成状态:LeWM 架构
第 3 部分——防止模型作弊:预测损失与 SIGReg
第 4 部分——让模型行动起来:在潜在空间中规划
第 5 部分——工程复现:从论文到可运行系统
第 6 部分——LeWM 究竟学到了什么?
第 7 部分——为什么“预测准确”仍可能“规划很差”
第 8 部分——从复现者到研究者
附录
先看全景
- 检查数据顺序、动作、变换
- 检查计算图形状 + 梯度
- 检查健康有限、分布、动作利用
- 然后扩展长时间运行前先测滚动展开
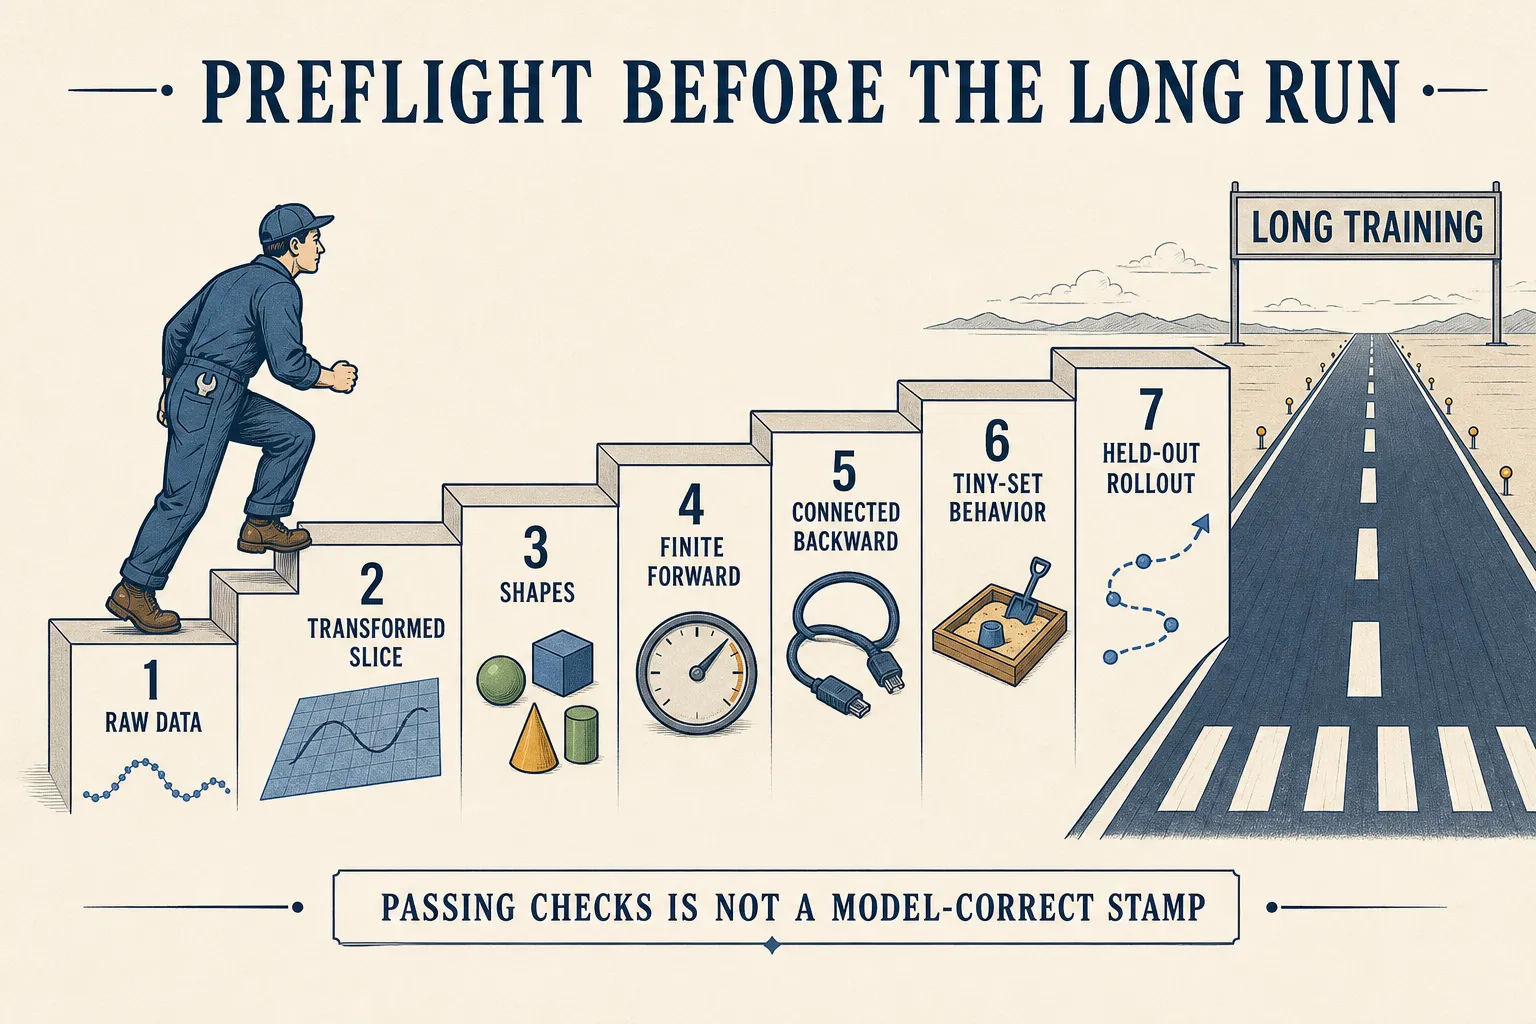
一个小故事
第一次运行让总损失持续下降,却把每张图像都变成了几乎相同的潜在状态。第二次运行在低精度下产生非有限值。第三次运行载入了模型权重,却悄悄重置了调度器和数据顺序。三个仪表盘看起来都让人放心。
冒烟测试不是成功证书。它会在接线错误吞噬漫长训练预算之前,以低成本排除特定故障。
技术背包
先记录来源信息:代码提交、解析后的配置、依赖版本、数据哈希、硬件、精度、初始化、加载器/划分状态、worker 策略、SIGReg 随机性、评估随机性和确定性内核例外。可见的 seed 用于构建划分/加载器生成器,并不能建立全局确定性。在接受检查的快照中,重要的 stable-pretraining 和 stable-worldmodel 版本都没有锁定。
分别检查变换前后的一条轨迹。冻结默认值使用 history 三、offset 一、frame skip 五,以及四个观测位置,共有三组移位样本对参与计算。非像素统计量是在划分数据集之前,从已经载入的完整数据集中计算的,并不只来自训练集。边界动作中的 NaN 会被替换为零;这个零是一种数据约定,不一定代表物理上的无操作。
batch 大小和投影数量解决不同问题。冻结 batch 大小为 128;每次 SIGReg 调用都在各时间切片上看到本次前向传播的群体。增加投影可以用更多方向检查同一群体。梯度累积可能增大优化器 batch,却不会增大单次 SIGReg 调用所使用的群体。
冻结训练以 AdamW 为起点:学习率 5e-5、weight decay 1e-3、warmup-cosine 调度、梯度裁剪 1.0,以及 bfloat16 混合精度。权重衰减不等于潜在高斯性;梯度裁剪也无法重新接通一条缺失分支。请记录实际学习率、各模块裁剪前的梯度、裁剪频率和中间值是否有限。
论文描述训练十个 epoch;冻结 YAML 则写着 max_epochs: 100。运行时覆盖可以使一次运行符合其中一种设置,但两个来源事实必须分开保留。应报告更新次数和已处理窗口数量,而不能只说“epoch 数”。
按下列顺序操作:
provenance
-> raw and transformed sequence
-> forward shapes + finite raw losses
-> backward signals in encoder/action/predictor paths
-> tiny-subset fit + latent spread + action swaps
-> held-out one-step + autoregressive error by horizon
-> then scale workers, epochs, precision, projections, or devices
一个模型权重文件可能足以进行评估,却不足以精确续训。恢复训练还可能需要优化器、调度器、步数、精度、随机状态和数据顺序状态。
容易骗过我们的把戏
对固定输入执行四种廉价干预:打乱动作;重复同一个动作;缩小 batch,直到 SIGReg 变得嘈杂;把一次 bfloat16 更新与一次全精度诊断更新相比较。每项干预只改变一种可疑机制,并且必须标为探针,而不是新的基准。
绝不能把健康状况压缩成单个分数。应记录原始预测损失、原始 SIGReg、加权总损失、学习率、梯度范数、非有限值计数、潜在矩与谱、动作交换、留出数据单步误差,以及按时域划分的记录动作滚动展开。广泛分布的点云可以与听不见动作的动力学并存;良好的单步曲线也可以与漂移并存。
证据凭据
LeWorldModel v3、冻结的 train.py、utils.py 和 module.py,支持这些来源设置。
单随机种子的 TwoRoom 复现 发现,要让其预测器在十个 epoch 的预算内开始下降,需要稠密动作收集、运行时动作宽度、ImageNet 像素标准化和动作 z-score。它还发现:当投影器 BatchNorm 的运行方差远小于当前激活尺度时,验证结果会出现最高达 300× 的伪影;发布的作者检查点不满足第一个条件,因此不受影响。这些都是范围有限的诊断结果,不能视为普遍因素,也不能据此断言作者训练失败。
快速检查
- 为什么增加投影不能替代增加 batch 样本?
- 在极小子集上成功拟合能证明什么,又不能证明什么?
- 哪些状态能区分模型导出文件和可恢复训练的完整实验?